Najtrudniejsze są dane
Każda gmina publikuje harmonogram inaczej. Wiele z nich wrzuca skan albo zdjęcie wydrukowanego kalendarza: dwanaście miesięcy na jednej stronie, kolorowe dni i legenda w rogu.
Najprostszy pomysł to dać modelowi całą stronę i poprosić o daty. Na sześciu trudnych skanach najlepsza wersja takiego promptu pomyliła 24,5% komórek. Na stronie są setki podobnych liczb, a tam, gdzie model nie widzi wyraźnie każdego dnia, dopowiada regularny wzór. W Wiśniewie worki bio jeżdżą raz w miesiącu, a prompt z całą stroną dał wywóz co tydzień.
Jak czyta to pipeline
- Tnie stronę na miesiąceModel wskazuje ramki miesięcy, kod przesuwa granice do pustego pasa między nimi, a wycinek odpada, jeśli ostatni widoczny dzień się nie zgadza.
- Czyta każdy kawałek dwa razyKażdy miesiąc czytają dwa prompty, z dołączoną legendą. Tabele dostają drugi obraz z rozsuniętymi kolumnami.
- Remis rozstrzyga większośćGdy dwa odczyty się różnią, decyduje trzeci.
- Kod sprawdza to, co pewneNiedziele, święta, dziury w rytmie, liczbę wierszy i to, czy każdy adres z państwowego rejestru trafia do dokładnie jednej strefy.
- Lepiej wstrzymać niż zgadywaćWątpliwość, której odczyty nie rozstrzygnęły, wstrzymuje strefę. Brak harmonogramu jest bezpieczniejszy niż zła data.
Wyniki
Sześć skanów i zdjęć z 2190 komórkami. Pipeline przeczytał każdy z nich w trzech pełnych przebiegach, razem 6570 wyników. Komórka to jedna miejscowość, jeden rodzaj odpadów i jeden miesiąc. Jest dobra tylko wtedy, gdy każdy dzień zgadza się z dokumentem.
Zielone są dobre, czerwone złe, szare wstrzymane. Wzorzec to 966 decyzji, które podjąłem ręcznie w panelu. Pipeline był dostrajany na tych dokumentach, więc zero złych dat to jego najlepszy wynik, na dokumentach, które już zna. Następny test to dokumenty, których nie widział.
| Dokument | Komórki | Błędy promptu | Błędy pipeline'u | Wstrzymane |
|---|---|---|---|---|
| Gierałtów, zdjęcie | 120 | 57,2% | 0 | 0% |
| Czerna, zdjęcie | 112 | 86,9% | 0 | 0% |
| Wykroty, zdjęcie | 120 | 76,7% | 0 | 0% |
| Wiśniew, skan | 147 | 77,8% | 0 | 33,3% |
| Szprotawa, skan bokiem | 264 | 1,0% | 0 | 74,2% |
| Klimontów, trzystronicowy skan tabel | 1427 | 11,3% | 0 | 10,1% |
| Wszystkie sześć | 2190 | 24,5% | 0 | 17,8% |
Nie wszędzie jest lepszy: w Szprotawie prompt był prawie bezbłędny, a pipeline wstrzymał trzy czwarte komórek. Jest też droższy: jedno zapytanie i około 25 sekund na dokument dla promptu, wobec mediany 33 zapytań i 4,5 minuty.
Co zbudowałem
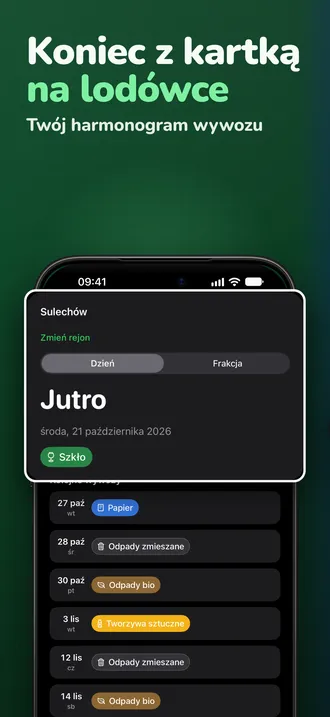
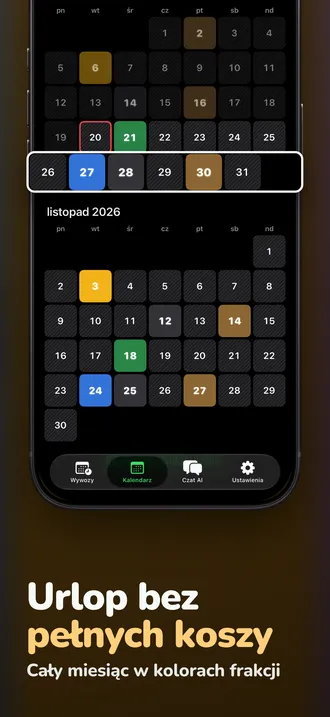
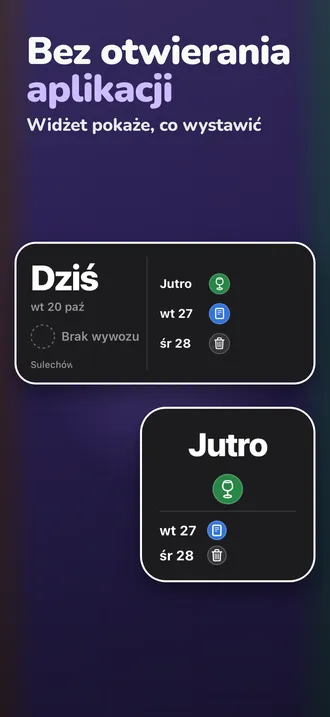
- Aplikację na iPhone'a w SwiftUI, z widżetami, Live Activity, przypomnieniami, które można odłożyć albo oznaczyć jako zrobione, i harmonogramem działającym offline.
- Aplikację na Androida w Kotlinie i Jetpack Compose. Jest gotowa, ale jeszcze nie ma jej w Google Play.
- Backend w FastAPI i PostgreSQL: wyszukiwanie adresów w państwowym rejestrze TERYT, harmonogramy serwowane jako statyczny JSON.
- Pipeline czytający harmonogramy w Pythonie z OpenCV, Tesseractem, PyMuPDF i Gemini oraz panel administracyjny w React i TypeScripcie.
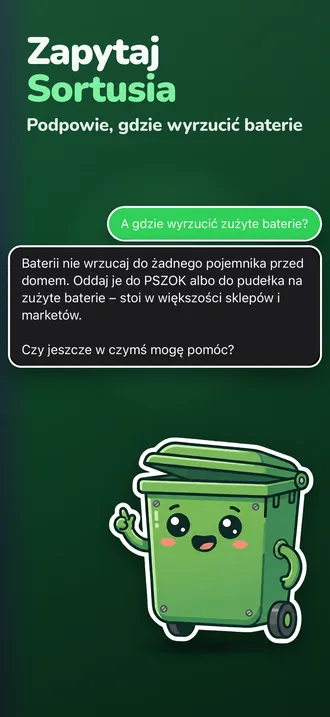
- Sortusia, asystenta, który odpowiada na pytania na podstawie harmonogramu mieszkańca.
W aplikacji jest sześć opublikowanych gmin. EcoSort w App Store. Strona aplikacji to ecosort.pl.