Mateusz Śliwa
Inżynier danych i AI, który dowozi aplikacje mobilne.
Zielona Góra. Otwarty na pracę zdalną lub hybrydową i na przeprowadzkę. Dostępny od zaraz.
Magister inżynierii danych, Uniwersytet Zielonogórski, 2026. Angielski C1, Cambridge C1 Advanced (2025).
Pracuję z agentami do kodowania: Claude Code, Codex i Cursor.
To jest mój telefon. Każda aplikacja otwiera działające demo projektu. Przeciągnij kreskę na dole w górę, żeby przeglądać je jak karty.
Pobierz CVGitHub[email protected]
W App Store: EcoSort i TrueSky. Strona EcoSort to ecosort.pl.
Projekty
Każda karta otwiera całą historię: co robi projekt, co było trudne i co zbudowałem.
Zdjęcie wydrukowanego kalendarza wywozów, czytane miesiąc po miesiącu
 EcoSortTerminy wywozu śmieci dla twojej ulicy
EcoSort pokazuje, które pojemniki wystawić na twojej ulicy i kiedy. Przypomina wieczorem dzień wcześniej, a widżet i ekran blokady pokazują, co dalej.
Najtrudniejsze są dane
Każda gmina publikuje harmonogram inaczej. Wiele z nich wrzuca skan albo zdjęcie wydrukowanego kalendarza: dwanaście miesięcy na jednej stronie, kolorowe dni i legenda w rogu.
Najprostszy pomysł to dać modelowi całą stronę i poprosić o daty. Na sześciu trudnych skanach najlepsza wersja takiego promptu pomyliła 24,5% komórek. Na stronie są setki podobnych liczb, a tam, gdzie model nie widzi wyraźnie każdego dnia, dopowiada regularny wzór. W Wiśniewie worki bio jeżdżą raz w miesiącu, a prompt z całą stroną dał wywóz co tydzień.
Jak czyta to pipeline
- Tnie stronę na miesiąceModel wskazuje ramki miesięcy, kod przesuwa granice do pustego pasa między nimi, a wycinek odpada, jeśli ostatni widoczny dzień się nie zgadza.
- Czyta każdy kawałek dwa razyKażdy miesiąc czytają dwa prompty, z dołączoną legendą. Tabele dostają drugi obraz z rozsuniętymi kolumnami.
- Remis rozstrzyga większośćGdy dwa odczyty się różnią, decyduje trzeci.
- Kod sprawdza to, co pewneNiedziele, święta, dziury w rytmie, liczbę wierszy i to, czy każdy adres z państwowego rejestru trafia do dokładnie jednej strefy.
- Lepiej wstrzymać niż zgadywaćWątpliwość, której odczyty nie rozstrzygnęły, wstrzymuje strefę. Brak harmonogramu jest bezpieczniejszy niż zła data.
Wyniki
Sześć skanów i zdjęć z 2190 komórkami. Pipeline przeczytał każdy z nich w trzech pełnych przebiegach, razem 6570 wyników. Komórka to jedna miejscowość, jeden rodzaj odpadów i jeden miesiąc. Jest dobra tylko wtedy, gdy każdy dzień zgadza się z dokumentem.
Zielone są dobre, czerwone złe, szare wstrzymane. Wzorzec to 966 decyzji, które podjąłem ręcznie w panelu. Pipeline był dostrajany na tych dokumentach, więc zero złych dat to jego najlepszy wynik, na dokumentach, które już zna. Następny test to dokumenty, których nie widział.
| Dokument | Komórki | Błędy promptu | Błędy pipeline'u | Wstrzymane |
|---|---|---|---|---|
| Gierałtów, zdjęcie | 120 | 57,2% | 0 | 0% |
| Czerna, zdjęcie | 112 | 86,9% | 0 | 0% |
| Wykroty, zdjęcie | 120 | 76,7% | 0 | 0% |
| Wiśniew, skan | 147 | 77,8% | 0 | 33,3% |
| Szprotawa, skan bokiem | 264 | 1,0% | 0 | 74,2% |
| Klimontów, trzystronicowy skan tabel | 1427 | 11,3% | 0 | 10,1% |
| Wszystkie sześć | 2190 | 24,5% | 0 | 17,8% |
Nie wszędzie jest lepszy: w Szprotawie prompt był prawie bezbłędny, a pipeline wstrzymał trzy czwarte komórek. Jest też droższy: jedno zapytanie i około 25 sekund na dokument dla promptu, wobec mediany 33 zapytań i 4,5 minuty.
Co zbudowałem
- Aplikację na iPhone'a w SwiftUI, z widżetami, Live Activity, przypomnieniami, które można odłożyć albo oznaczyć jako zrobione, i harmonogramem działającym offline.
- Aplikację na Androida w Kotlinie i Jetpack Compose. Jest gotowa, ale jeszcze nie ma jej w Google Play.
- Backend w FastAPI i PostgreSQL: wyszukiwanie adresów w państwowym rejestrze TERYT, harmonogramy serwowane jako statyczny JSON.
- Pipeline czytający harmonogramy w Pythonie z OpenCV, Tesseractem, PyMuPDF i Gemini oraz panel administracyjny w React i TypeScripcie.
- Sortusia, asystenta, który odpowiada na pytania na podstawie harmonogramu mieszkańca.
W aplikacji jest sześć opublikowanych gmin. EcoSort w App Store. Strona aplikacji to ecosort.pl.
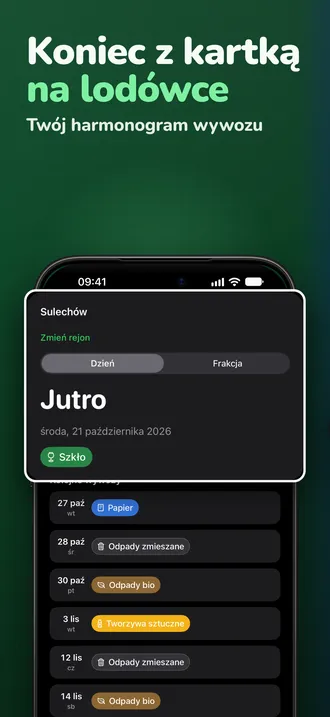
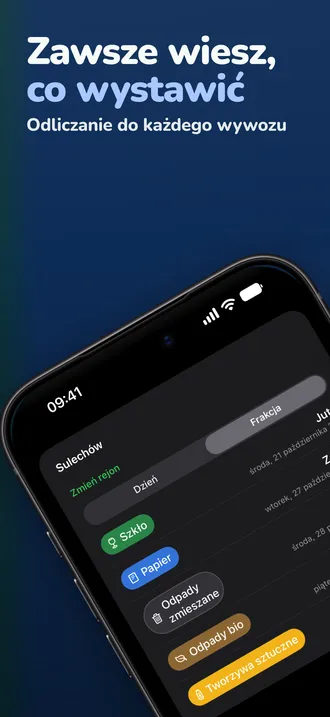
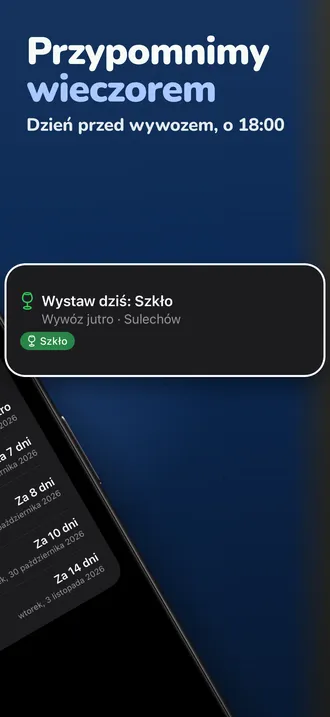
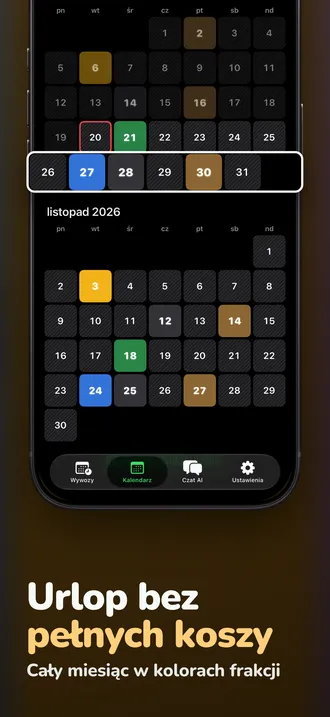
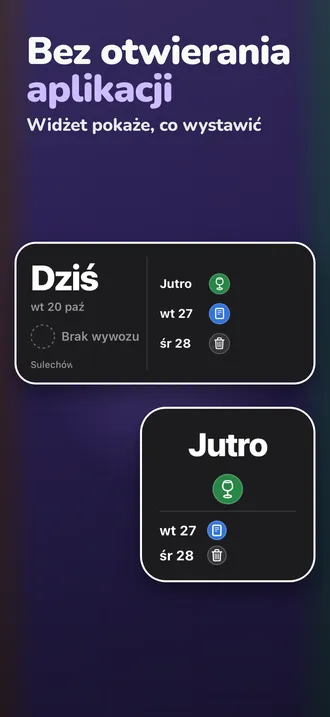
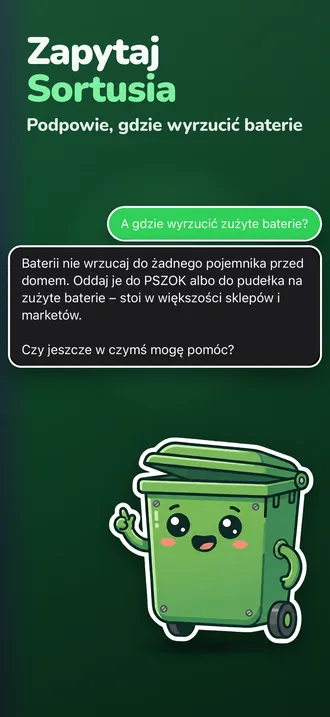
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/ecosort.
Gra na mózg, w której wynik liczy serwer
 KeenwitDwie gry do wypróbowania: Equinox i Star Sectors
Keenwit to codzienny trening mózgu: 43 krótkie gry na pamięć, matematykę, język i skupienie, z seriami, pojedynkami i rankingami. Trudność dopasowuje się do gracza. Nazwa jest robocza.
Dlaczego wynik liczy serwer
Można grać offline, więc telefon nie może być sędzią. Skończona gra czeka w kolejce na telefonie i nie zmienia XP, serii ani rankingu, dopóki serwer jej nie sprawdzi.
- Jednorazowy seedGry z losowaniem dostają seed od serwera. Powtórzony, przeterminowany albo niepasujący seed jest odrzucany.
- Okno czasoweWynik może być najwyżej 5 minut w przyszłości i 30 dni wstecz, więc gry offline nadal się liczą.
- Limit zapytańOsobno dla każdego klienta.
- Wynik normalizowany na serwerzeBardzo wysokie wyniki wymagają dodatkowego dowodu.
- WerdyktPrzyjęty, wstrzymany do sprawdzenia albo odrzucony. XP dają tylko przyjęte wyniki.
Prime Check: odpowiedzi trzyma serwer
W tej grze serwer idzie krok dalej. Generuje pytania, zachowuje odpowiedzi i wysyła telefonowi same liczby. Telefon rozgrywa je offline i odsyła to, co kliknąłeś. Serwer przelicza wynik ze swojej kopii i ignoruje wynik podany przez telefon. Na razie tylko ta gra ma taką kontrolę.
Demo: dwie gry
W telefonie są dwie z 43 gier. W Equinox wypełniasz planszę planetami i kometami: nigdy trzy takie same w linii, po połowie każdego rodzaju, a połączenia = i × muszą się zgadzać. Star Sectors to łamigłówka w stylu Queens: jedna gwiazda w każdym wierszu, kolumnie i kolorowym sektorze, a gwiazdy nigdy się nie stykają. Obie korzystają z zasad, plansz i punktacji z aplikacji. Każdy samouczek zaczyna się od kroków z aplikacji, a potem przechodzi na większą planszę z technikami, które ją rozwiązują: sektor zamknięty w jednym wierszu, luka między dwoma takimi samymi, pełne liczenie.
Jak jest zbudowany
React Native z Expo, TypeScriptem i Skią, na backendzie Fastify i PostgreSQL z logowaniem JWT i specyfikacją OpenAPI.
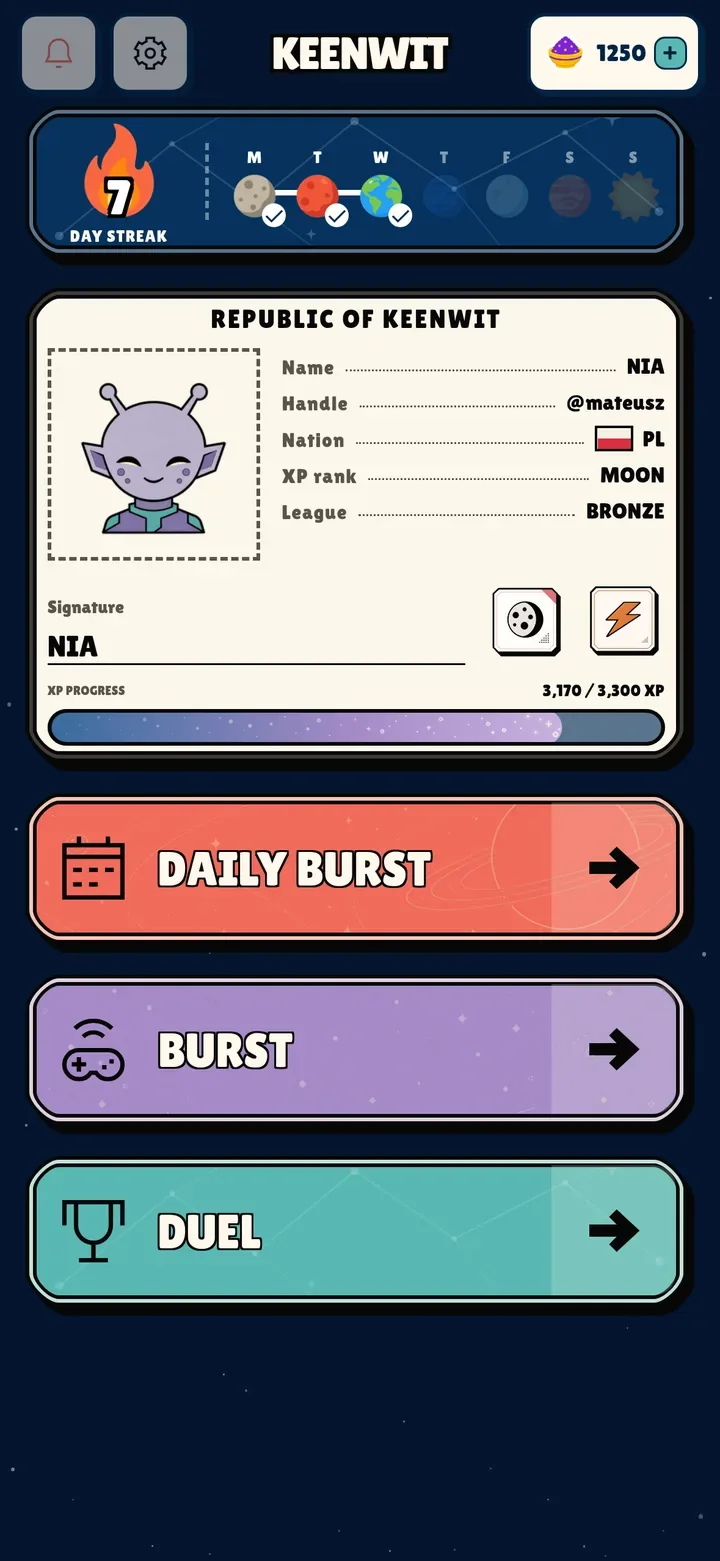
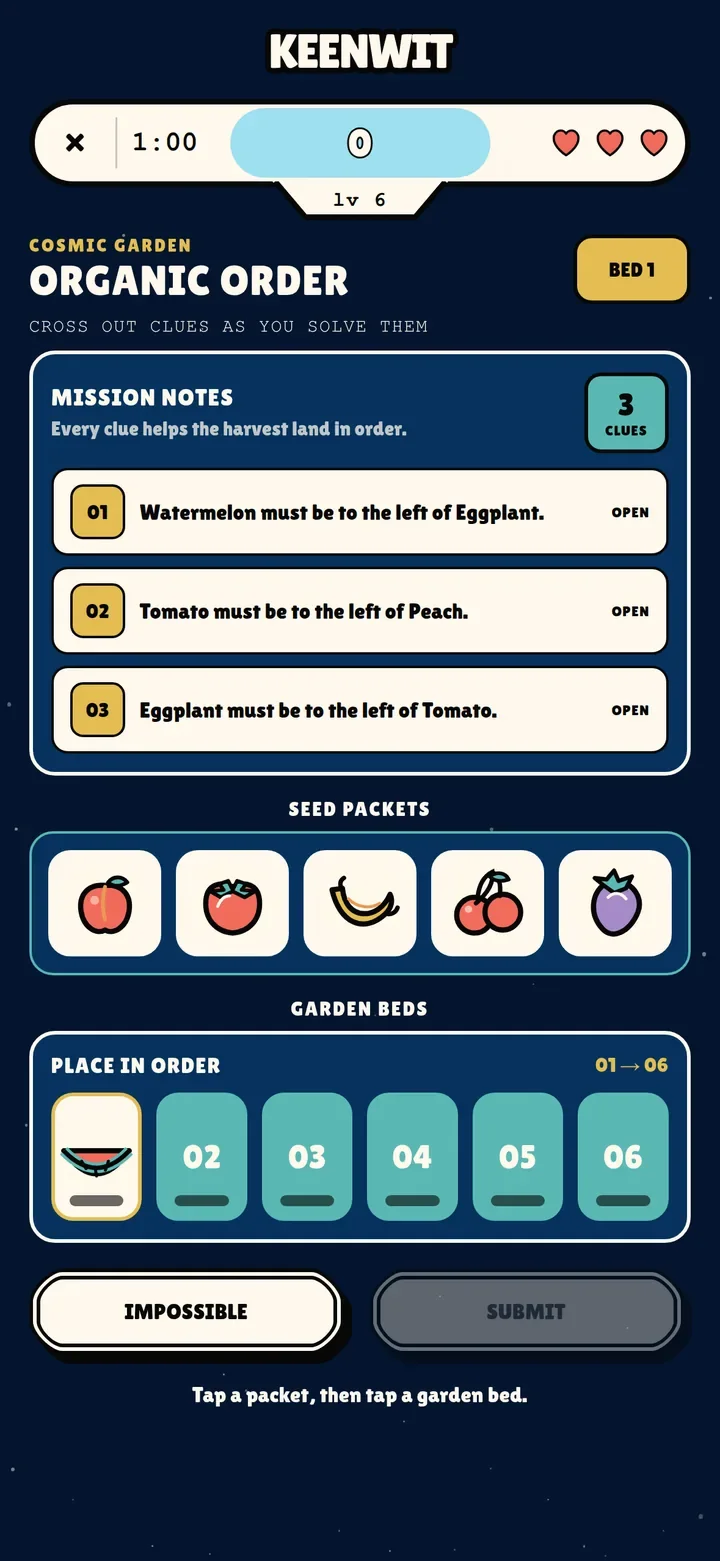
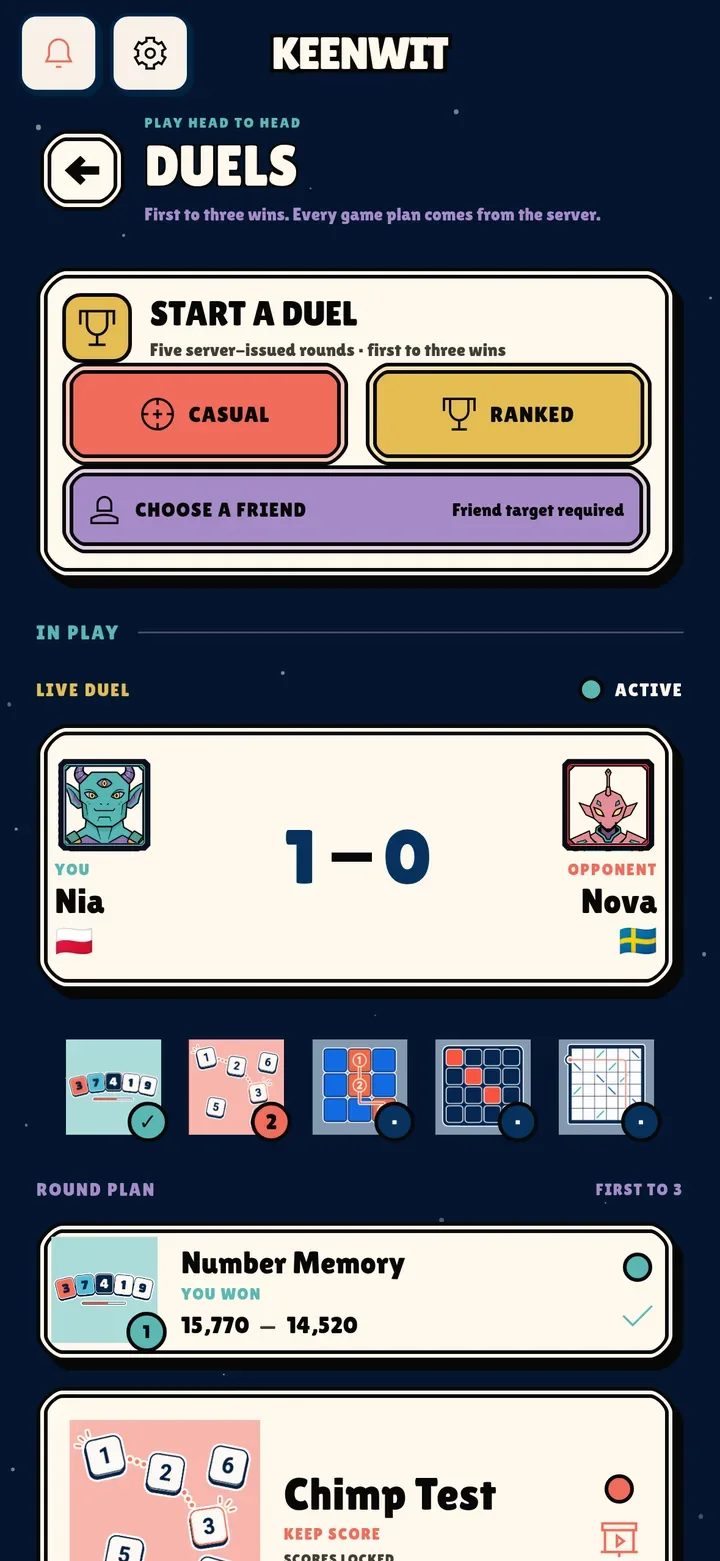
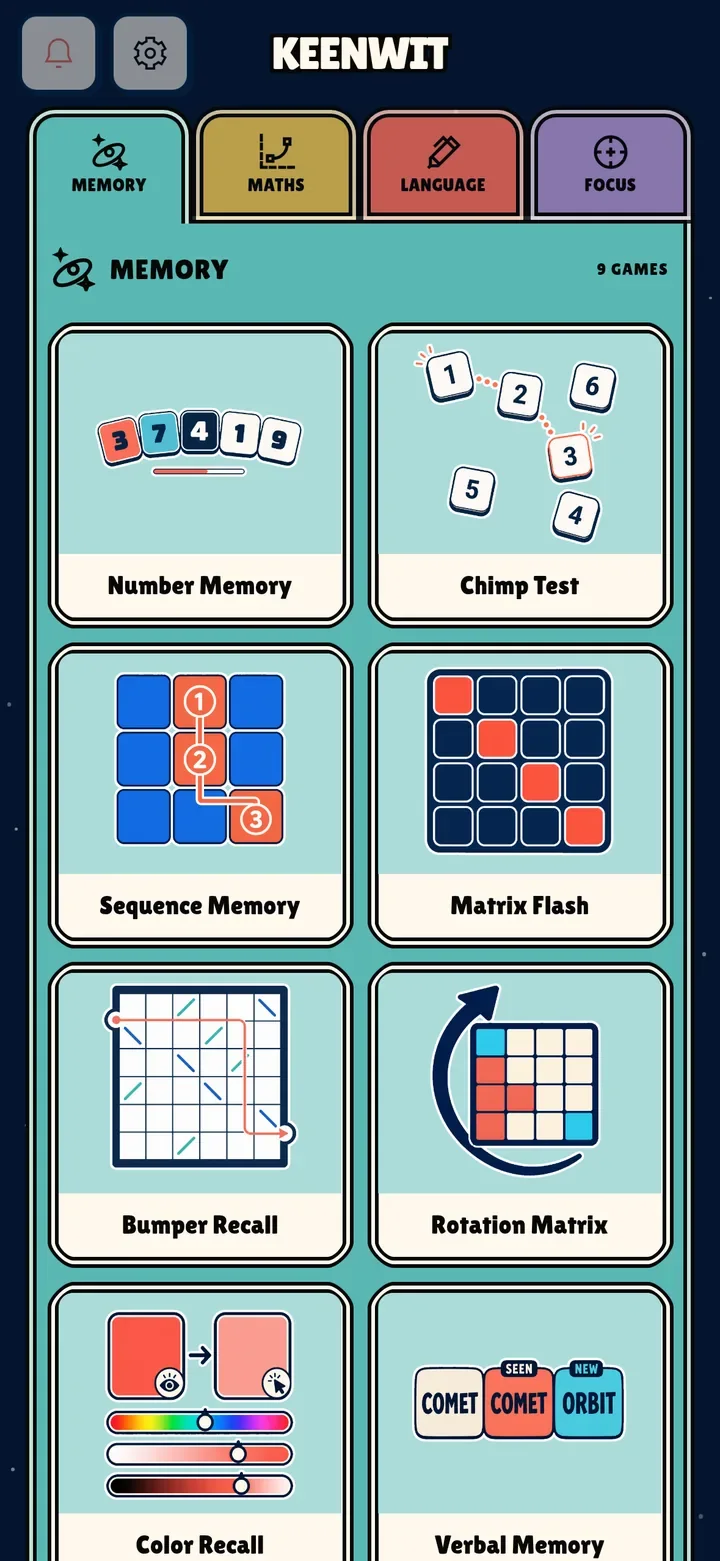
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/keenwit.
Pogoda, którą czytasz z obrazu
 TrueSkyMalowana pogoda, za darmo, z planem Pro
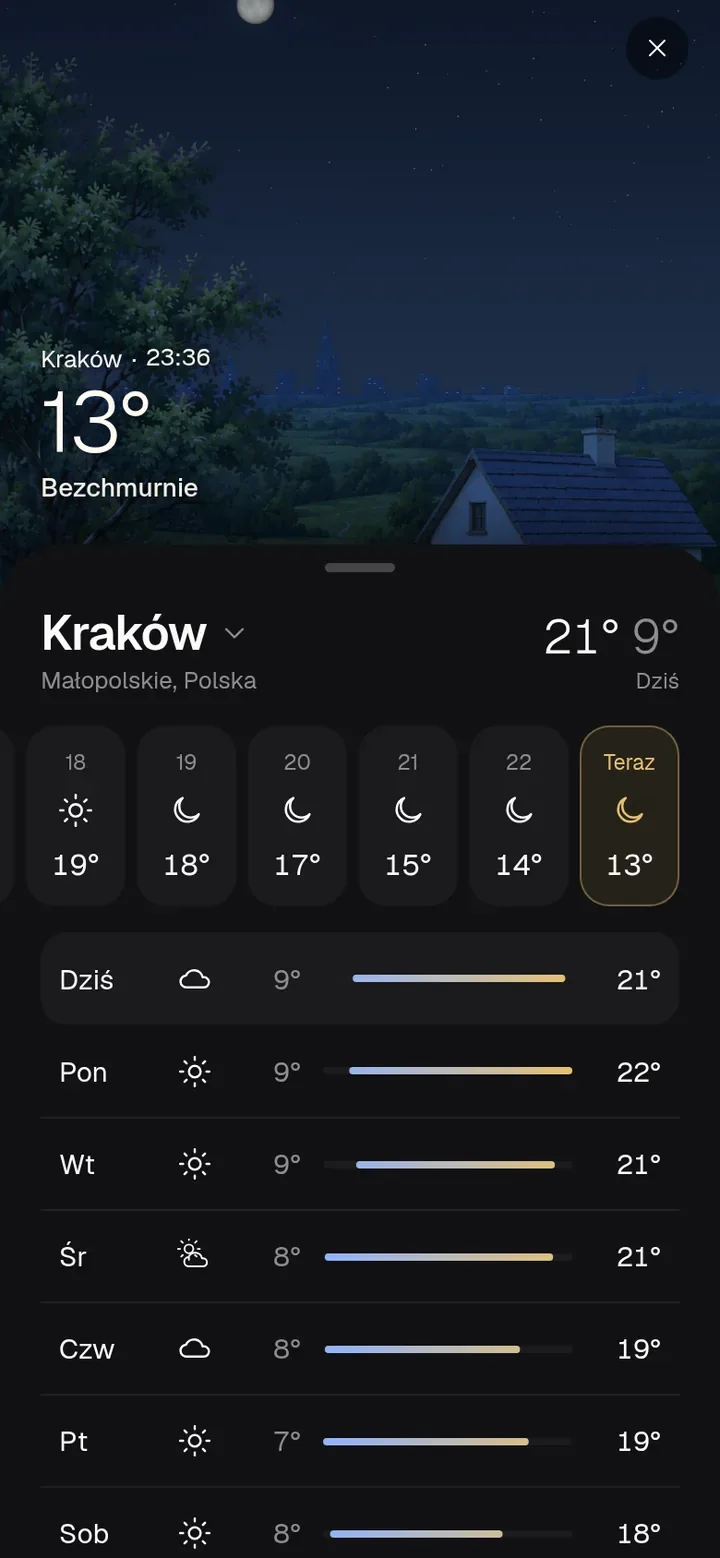
TrueSky rysuje pogodę jako malowany krajobraz. Godzinowa prognoza z Open-Meteo ustawia światło, chmury, wiatr i deszcz, a scena gra pasujący do nich dźwięk.
Jak działa scena
Każdy krajobraz to stos malowanych warstw: góry, woda, brzeg, chata, brzoza i łódka. Shadery Skia oświetlają je zależnie od godziny, od pierwszego światła po spokojną noc z zapalonymi oknami, przesuwają chmury z wiatrem i dodają deszcz, śnieg, mgłę albo burzę. Utrzymałem 120 Hz, ograniczając pracę wykonywaną w każdej klatce.
Strona biznesowa
Aplikacja jest darmowa. TrueSky Pro dodaje krajobrazy i szczegóły za 21,99 zł miesięcznie albo 55 zł jednorazowo, przez RevenueCat. Jest przetłumaczona na 32 języki i wysyła alerty pogodowe w tle. Od 9 października 2026 jest w App Store.
Expo, React Native, Skia, Reanimated, RevenueCat, Playwright dla wersji webowej.
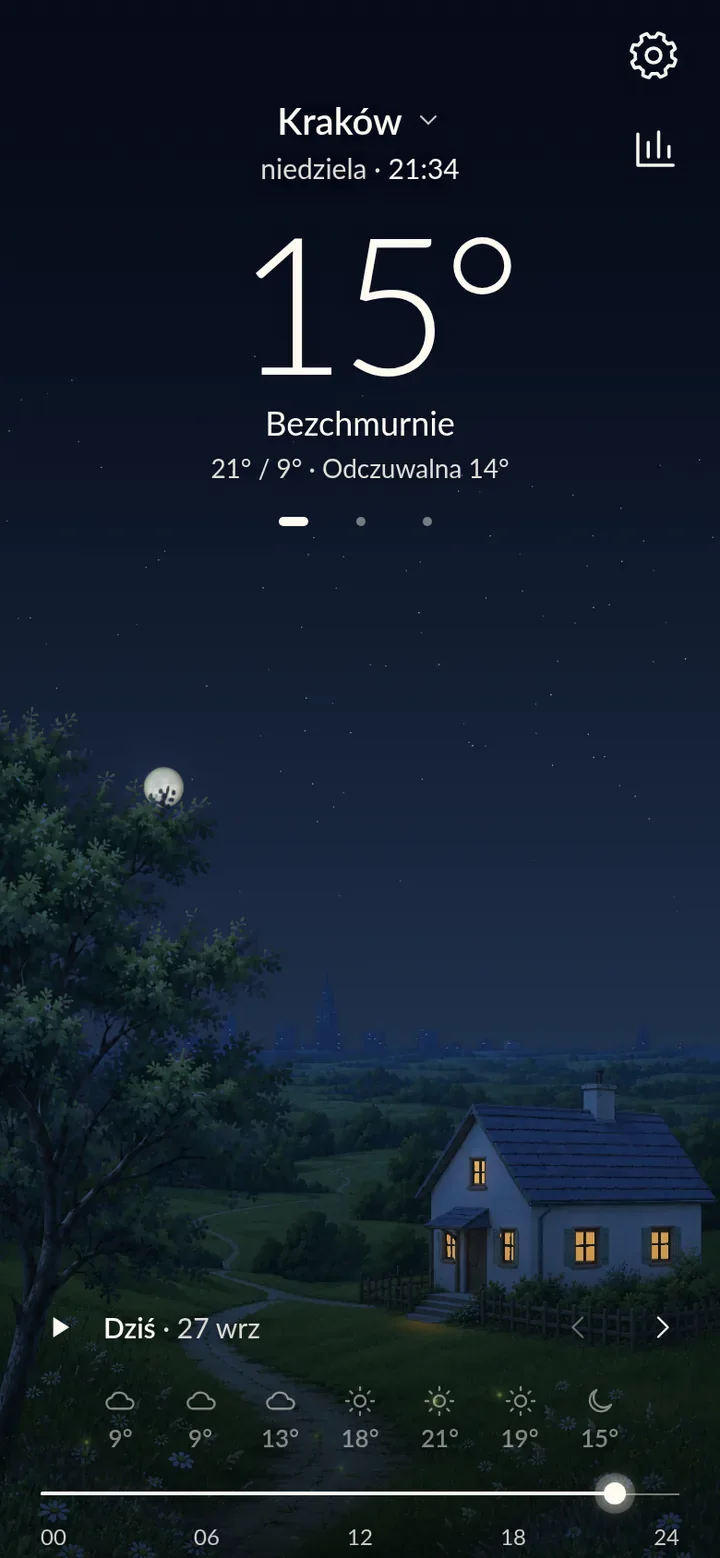
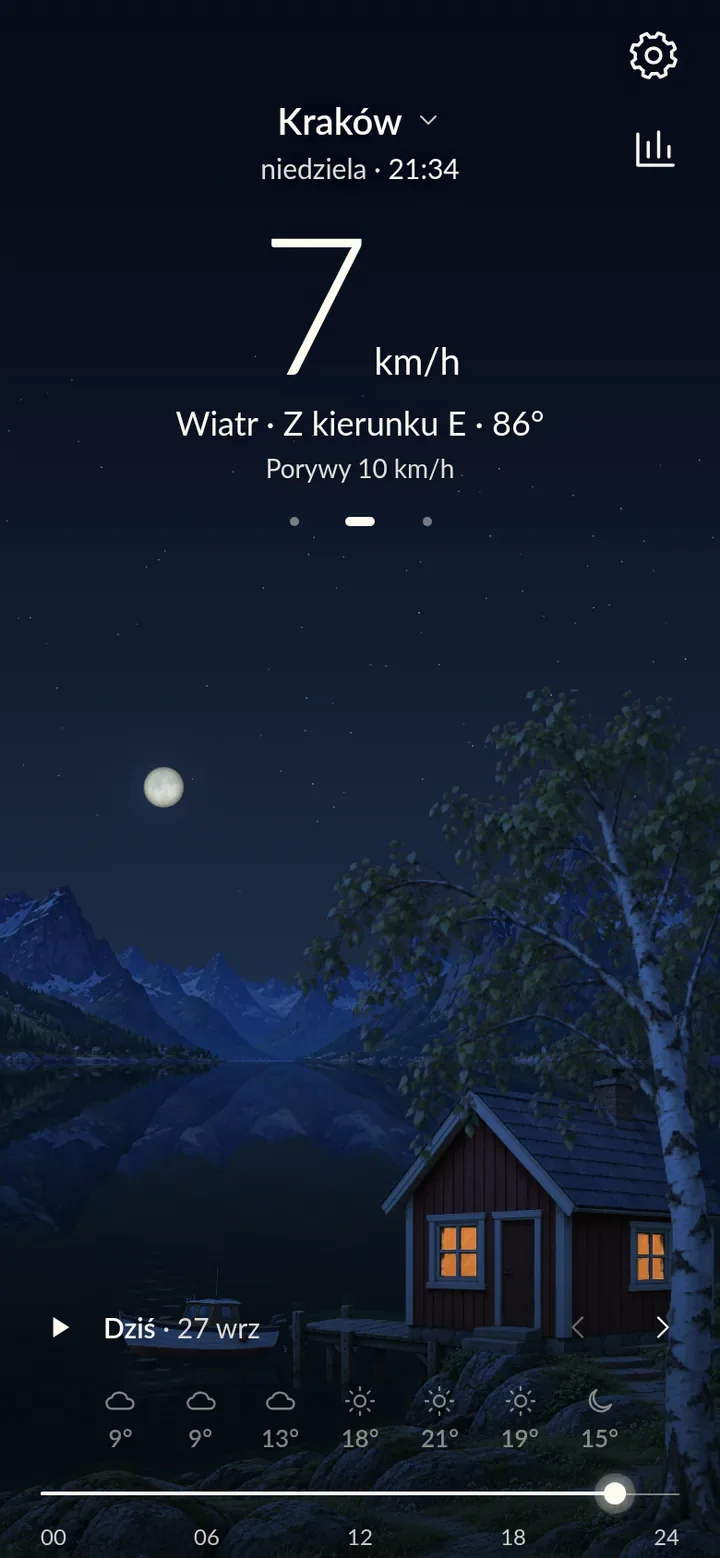
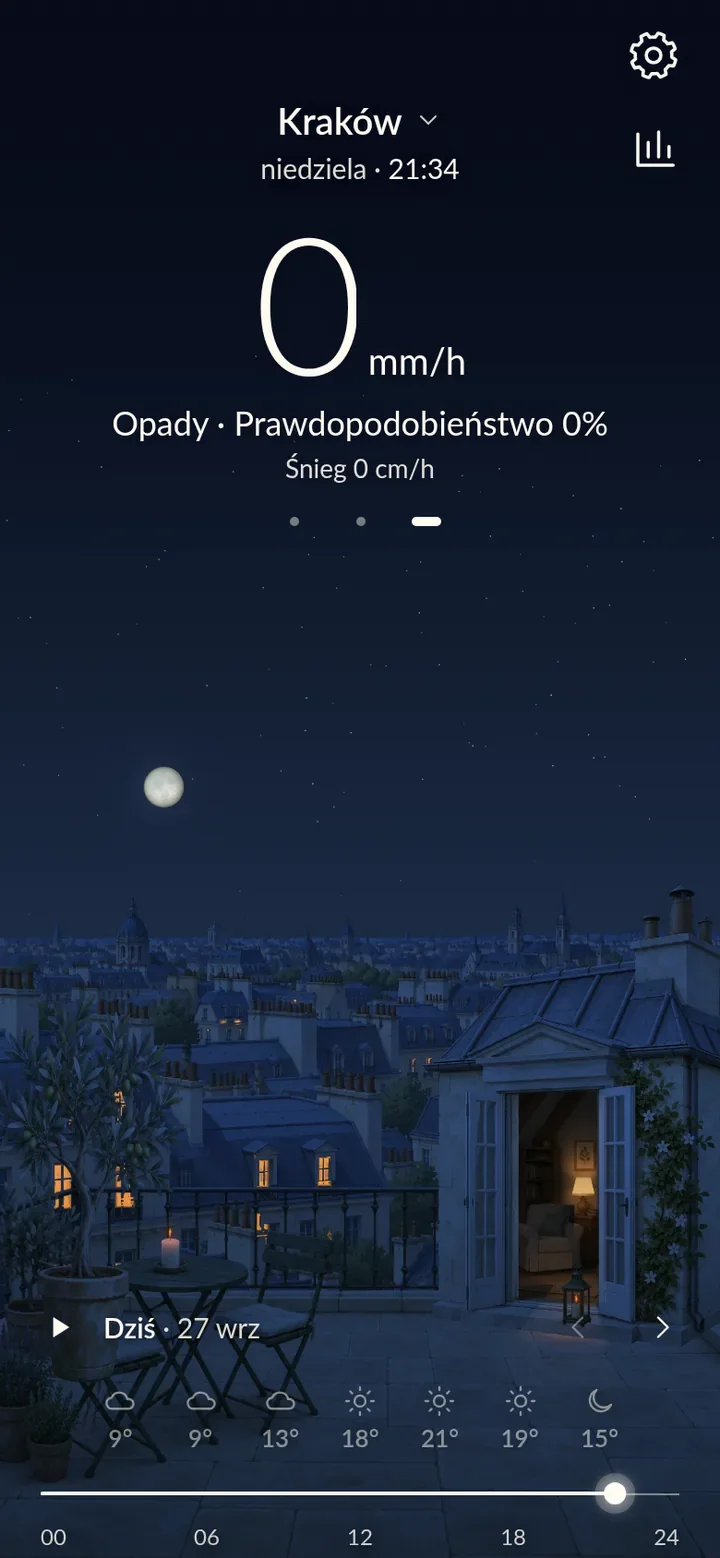
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/truesky.
Co zrobiłby X? Odpowiedzi słowami tej osoby
wwxd odpowiada na pytanie „co zrobiłby X?” słowami jednej konkretnej osoby. Pobiera jej publiczne napisy, transkrypcje podcastów i artykuły, robi z nich wiki jej poglądów, a agent odpowiada cytatami z tych źródeł ze znacznikami czasu.
Każdy cytat jest sprawdzany
Model potrafi przekręcić czyjeś słowa, więc skrypt szuka każdego cytatu w transkrypcji, z której pochodzi. W benchmarku znalazł co do słowa 158 ze 160 cytatów. Dwa brakujące to tytuły filmów.
Czy jest lepszy od samego Claude'a?
Na 40 pytaniach do dwóch wiki ślepy sędzia porównywał każdą odpowiedź wwxd z odpowiedzią samego Claude'a. Sędzia pochodził z innego laboratorium, z Google, i nie miał dostępu do transkrypcji. Wybrał wwxd w 34 z 40 pytań. Sędziowie z trzech kolejnych laboratoriów, w tym z Anthropic, ocenili te same pary i wybierali wwxd co najmniej tak samo często. Claude z wyszukiwaniem w sieci nie wypadł lepiej: sędzia z Google znów wybrał wwxd w 34 z 40 pytań.
W 24 pytaniach o opinię prompt, który kazał modelowi odpowiadać jako ta osoba, przeczył jej 8 razy. Odpowiedzi wwxd nie przeczyły jej ani razu.
Zapytaj panel
Tryb panelu pyta kilka osób naraz. Każda odpowiada ze swojej wiki. Potem wwxd pokazuje, w czym się zgadzają, w czym się różnią i dlaczego, prowadzi rundę debaty oznaczoną jako wniosek i kończy syntezą. Odpowiedzi są pisane prozą, a źródła są wypisane pod spodem.
Czego nie umie
Nie przewiduje poglądów, których ktoś jeszcze nie wyraził. Odłożyłem na bok stanowiska zajęte w 2026 roku i wwxd odgadywał je nie lepiej niż sam Claude. Wie, co ktoś powiedział, a nie co powie za chwilę.
Jak jest zbudowany
Narzędzie wiersza poleceń w Pythonie i plugin do Claude Code, zbudowane w październiku 2026 na licencji MIT. Projekt opiera się na pomyśle „LLM wiki” Andreja Karpathy'ego. Potrafi lokalnie transkrybować nagrania przez faster-whisper i sprawdzić po głosie, kto mówi. 12 października 2026 miał 135 testów, które działają w CI na Linuksie, macOS i Windowsie.
Python, Typer, yt-dlp, trafilatura, rapidfuzz, faster-whisper, Claude Code.
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/wwxd.
Plakaty dla małych firm bez generowania obrazów
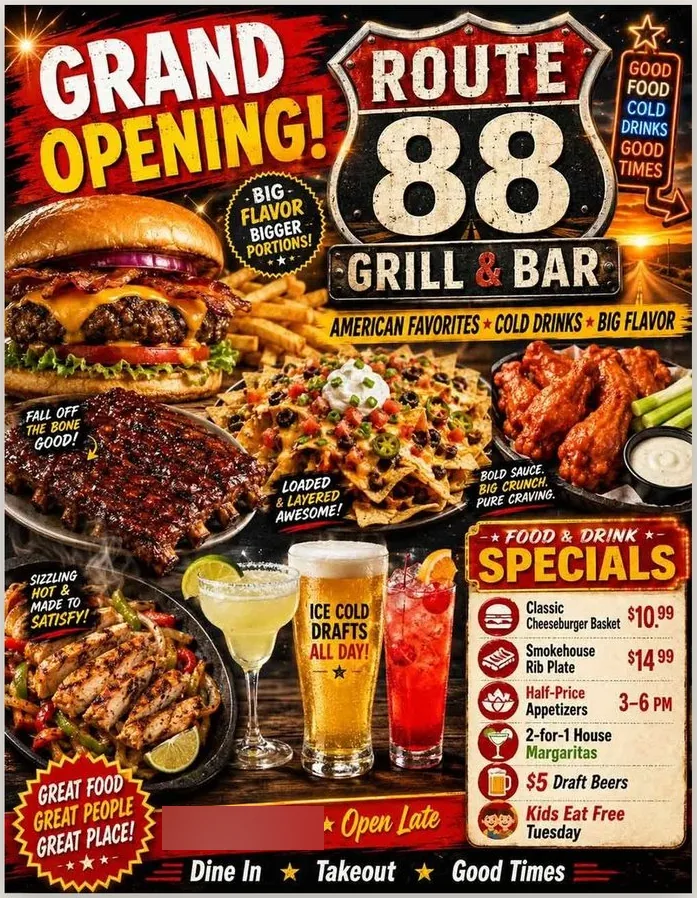
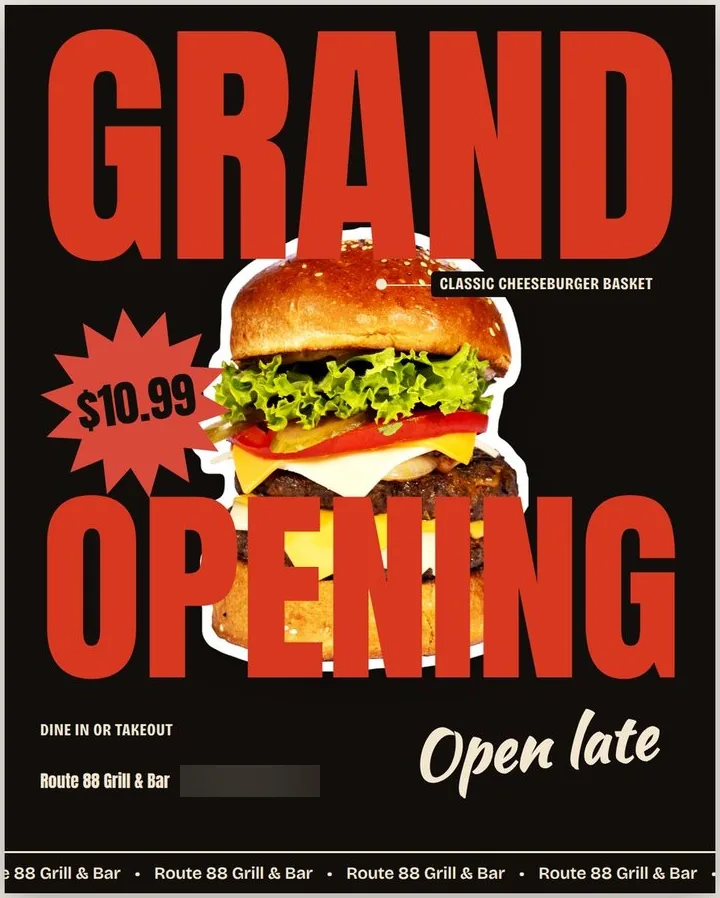
unslop (nazwa robocza) robi plakaty i grafiki do mediów społecznościowych dla małych firm bez generowania obrazów. Każda litera jest złożona prawdziwym fontem, a każde zdjęcie jest prawdziwe: własne zdjęcie właściciela albo licencjonowane zdjęcie stockowe. Projekt jest w budowie, a kod jest prywatny.
Przed i po
Każde „przed” poniżej to ulotka, którą opublikowała mała firma, zrobiona generatorem obrazów. Generator rysuje litery jako piksele i jeden z nagłówków wyszedł jako „AMAZINIG”. Każde „po” to ta sama treść zrobiona narzędziem, w którym tekst jest wpisany i złożony fontem.
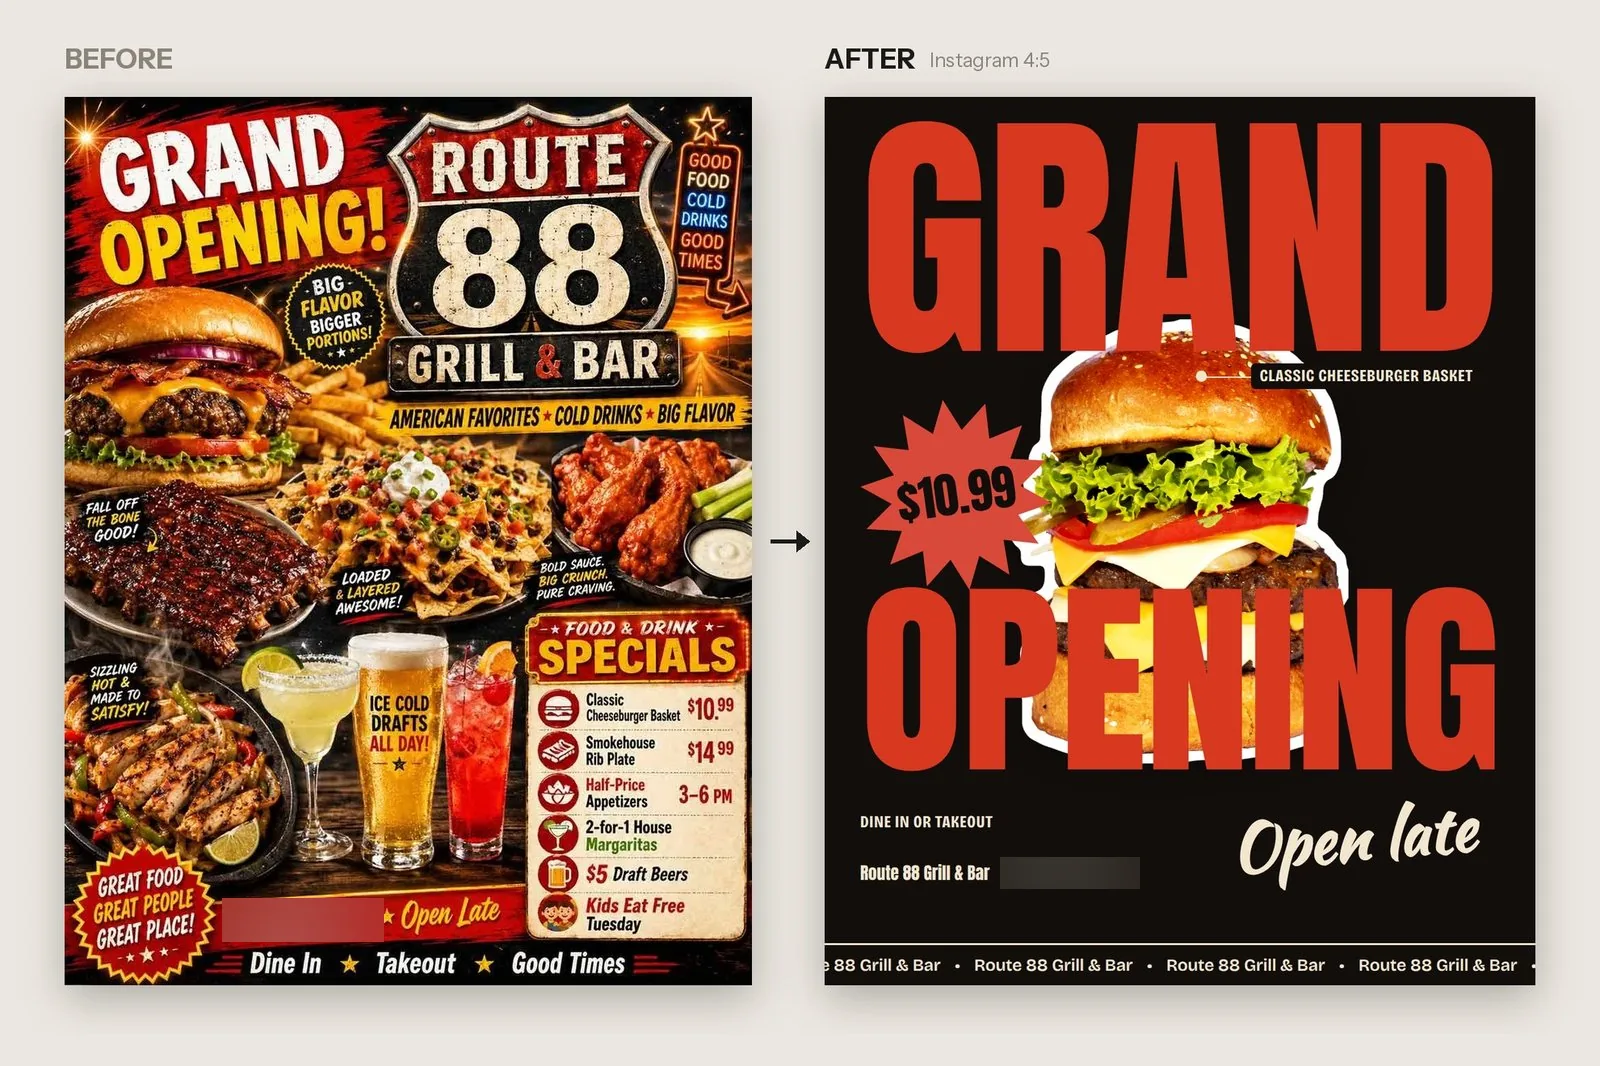
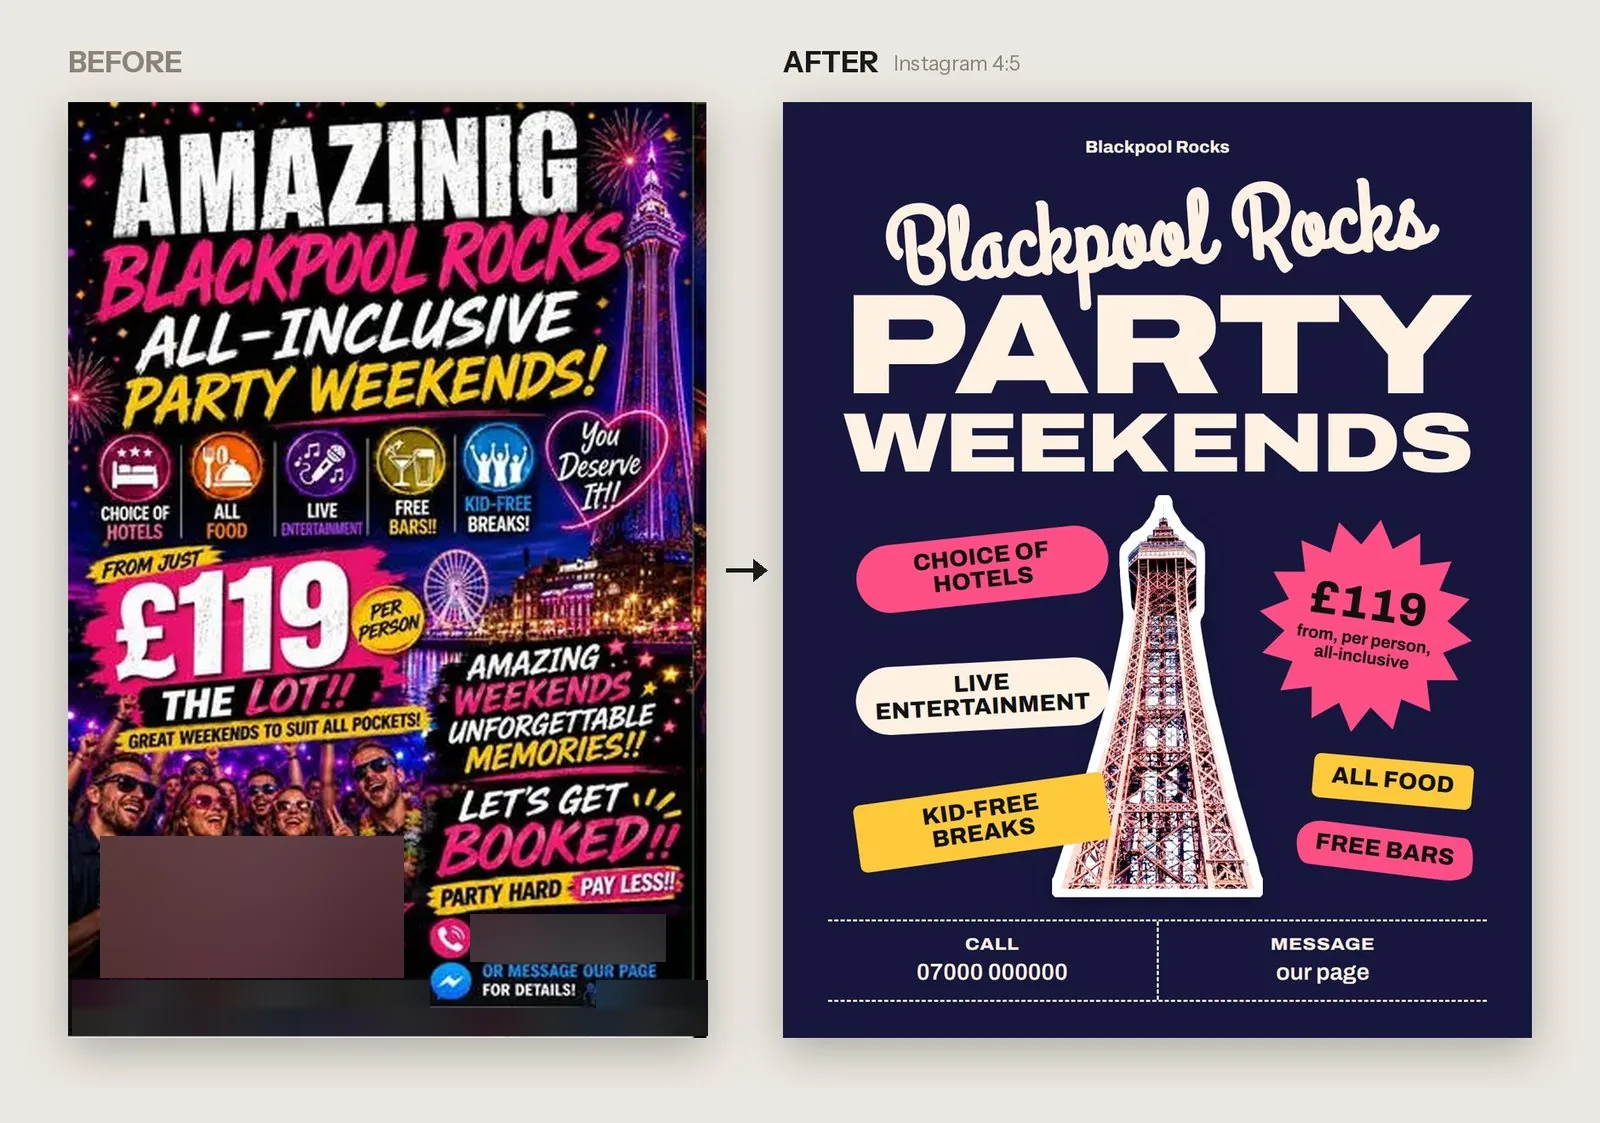
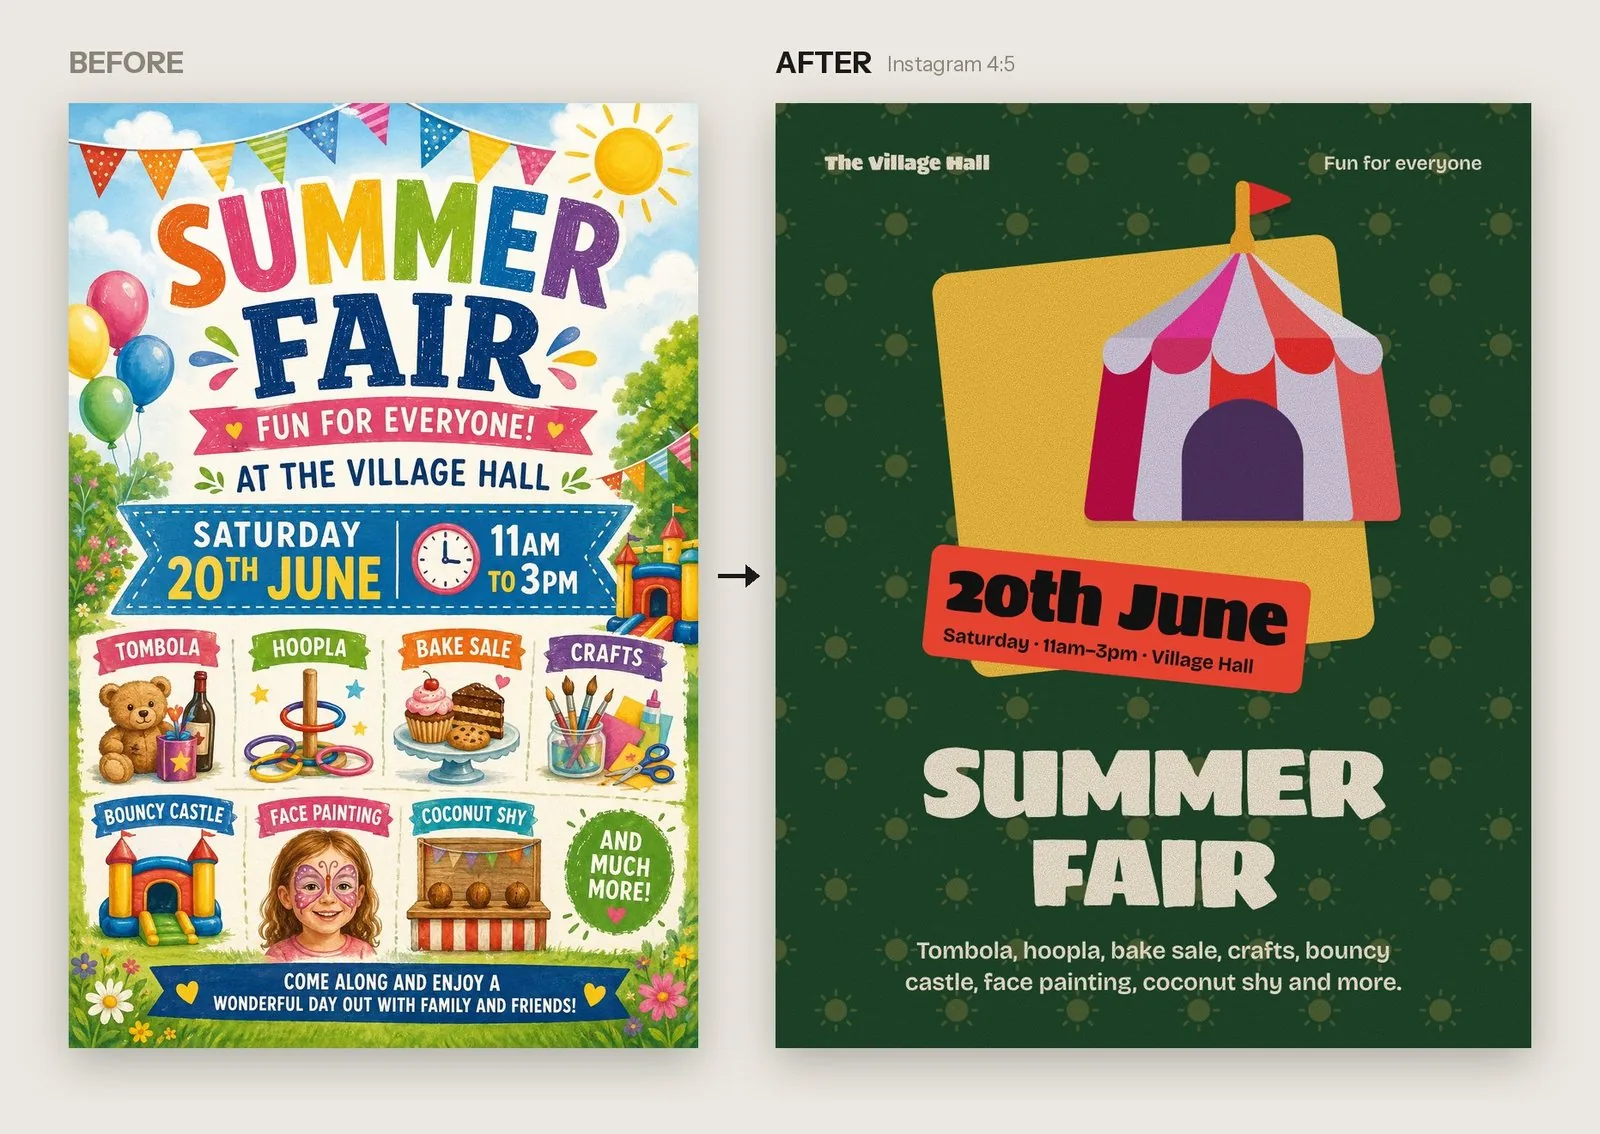
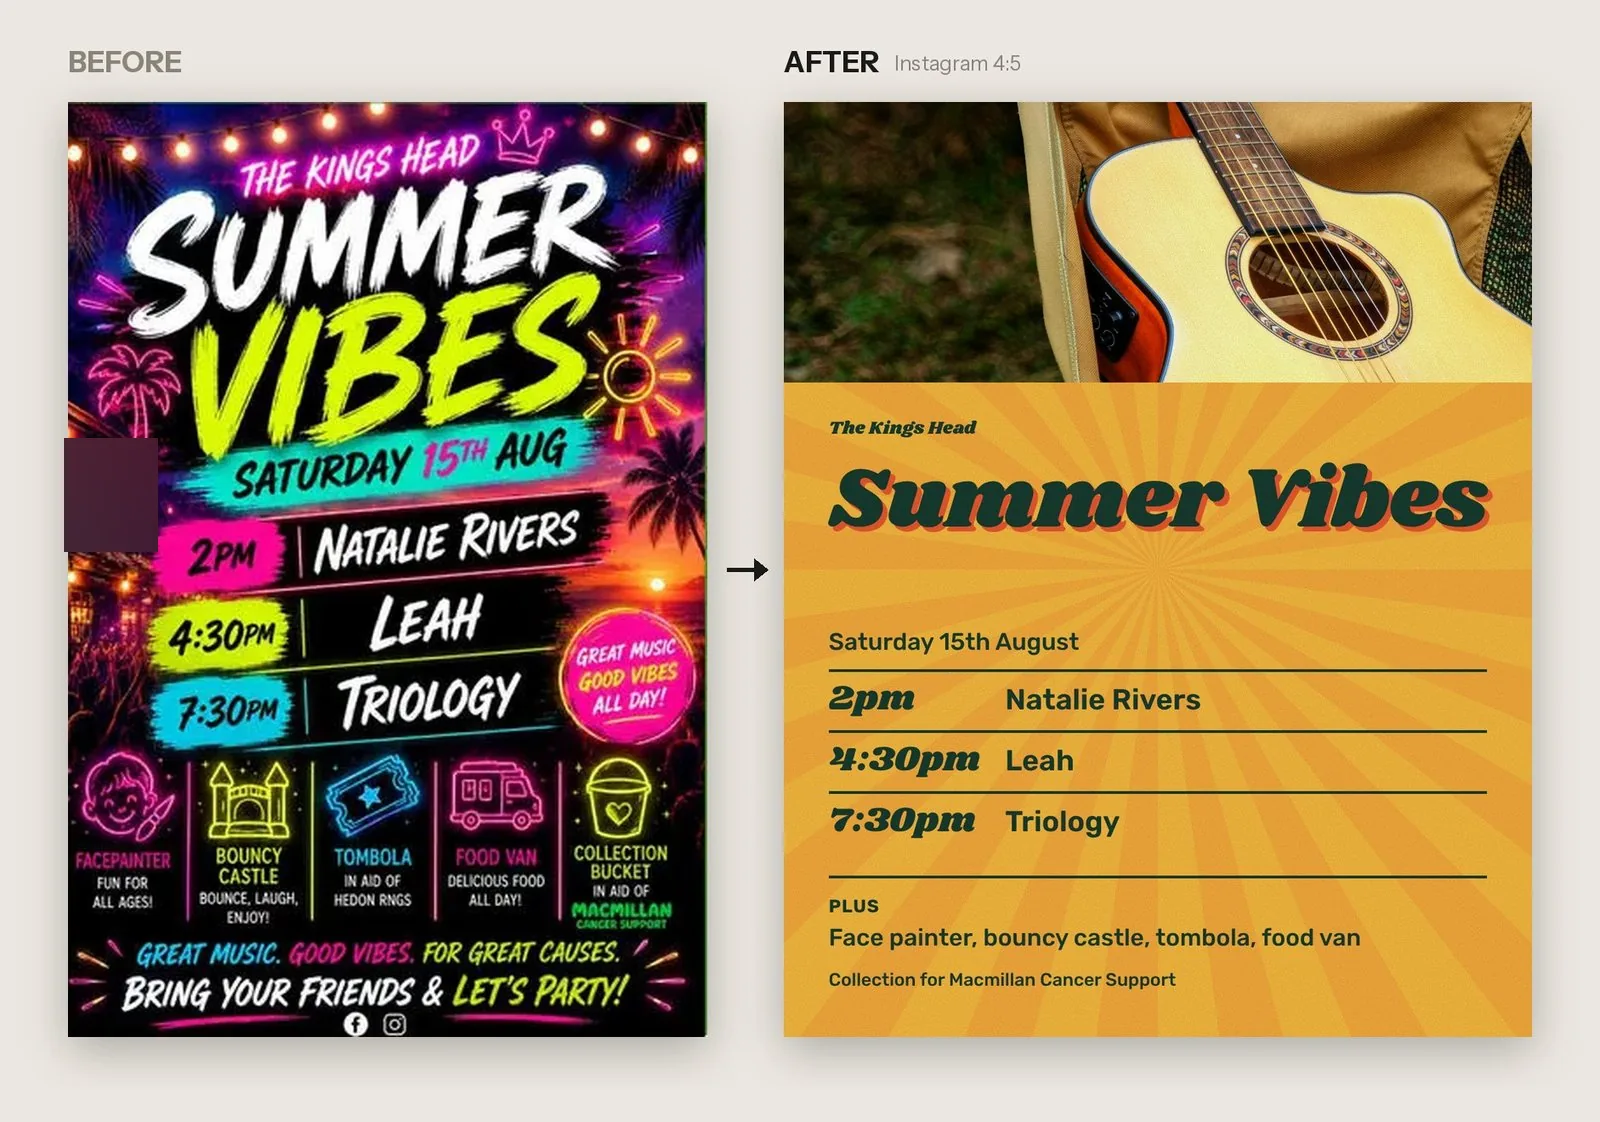
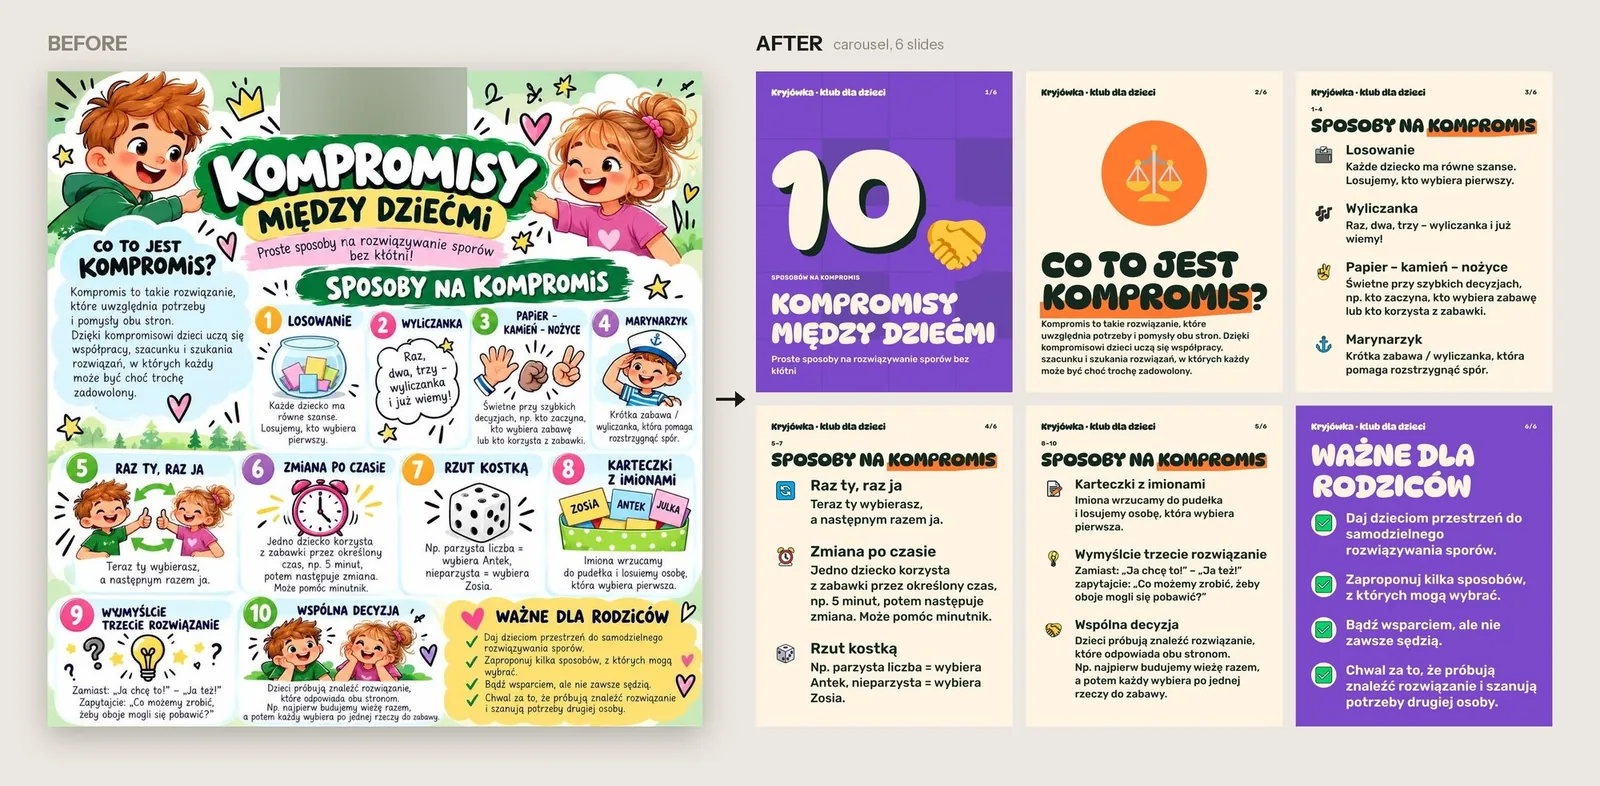
Plakaty „przed” to prawdziwe ulotki wygenerowane przez AI, które opublikowały małe firmy. Należą do swoich właścicieli i na prośbę usunę każdą z nich.
Jak to działa
- Agent pisze specyfikacjęMały plik JSON z układem, kolorami marki, tekstem i prawdziwym zdjęciem, własnym zdjęciem klienta albo licencjonowanym ze stocku.
- Renderer ją rysujeHTML i CSS w Chromium przez Playwright. Ta sama specyfikacja zawsze daje ten sam obraz.
- Linter sprawdza pikseleMierzy wyrenderowany obraz: tekst, który się nie mieści, nakładanie się elementów, kontrast z prawdziwym tłem, tekst schowany za głównym motywem, cenę, której nie widać, miejsca w relacji zasłonięte przyciskami Instagrama, powiększone zdjęcia i brakujące znaki w foncie.
- Agent poprawia to, co zgłosi linterZmienia specyfikację, a renderer rysuje ją od nowa.
Co robi
W październiku 2026 ma 20 układów i 15 kierunków wizualnych. Eksportuje posty na Instagram w 4:5 i 1:1, relacje w 9:16 oraz PDF-y do druku w A4, A3 i B2 ze spadami i osadzonymi fontami. Wyszukiwarka zdjęć przeszukuje Unsplash, Pexels, Pixabay i Openverse i zachowuje podpisy autorów. Usuwanie tła działa lokalnie, na procesorze.
Edytor dla właściciela
Właściciel sklepu klika dowolny tekst, żeby go zmienić. Cztery duże przyciski zmieniają układ, kolory, zdjęcie i tekst, a jedno kliknięcie pobiera wszystkie formaty. Opcjonalny asystent działa na Anthropic API ze streamingiem i cache'owanym promptem systemowym, a każda odpowiedź pokazuje, ile kosztowała.
Buduję z agentami do kodowania i wiem, jak ich ustawić
Większość tych projektów powstała z agentami do kodowania. Używam Claude Code, Codexa i Cursora obok siebie, śledzę nowe modele i funkcje na bieżąco i sprawdzam je na własnych projektach, zanim na nich polegam. Większość moich commitów od września 2026 ma Claude'a jako współautora.
Kontekst, który agent czyta najpierw
- Globalne zasady dla każdego agenta: znajdź istniejący wzorzec, zanim dodasz kod, trzymaj jedno źródło prawdy, naprawiaj przyczyny, raportuj tylko testy, które naprawdę się wykonały. Karta wyżej je cytuje.
- Instrukcje w repozytoriach, w AGENTS.md i CLAUDE.md, z komendami i pułapkami projektu, w Keenwit i pipelinie EcoSort.
- Skille do powtarzalnej pracy, w jednym folderze wspólnym dla Claude Code i Codexa. Dwa są moje: mac-ios do budowania i testowania aplikacji iOS z Linuksa oraz store-screenshots do storeshots.
- Subagenci do pracy, która dobrze się dzieli: równoległe przeszukiwanie, implementacja, niezależny przegląd i końcowe sprawdzenie.
Koszty, cache i limity
Stałe instrukcje idą na początek i się nie zmieniają, żeby prompt caching mógł je wykorzystać ponownie, a zmienne części idą na koniec. Pilnuję zużycia tokenów i limitów zapytań. Sortuś, asystent EcoSort, działa na puli kluczy API z dziennymi limitami, limitami na użytkownika i Gemmą jako zapasem.
Narzędzia, które buduję dla agentów
- storeshots zwraca JSON z każdej komendy, a jego błędy mówią, co się zepsuło, jak to naprawić i jaką komendę uruchomić dalej. Oba narzędzia mają dołączony skill dla agentów.
- macsim daje agentowi na moim linuksowym PC prawdziwy symulator iOS na Macu: buduje aplikację, przeklikuje ją i robi zrzuty ekranu. Open source, tak jak storeshots.
Sprawdzanie tego, co wraca
Odpowiedź modelu jest szkicem, dopóki nic jej nie sprawdziło. W EcoSort to dwa odczyty, trzeci przy niezgodności, kontrole w kodzie i ewaluacja na 966 decyzjach podjętych ręcznie. W Keenwit serwer sprawdza każdy wynik, zanim się policzy. Kod od agenta przechodzi to samo: testy i przegląd przed wydaniem.
Modele w moich aplikacjach
- Pipeline EcoSort czyta harmonogramy małym modelem Gemini, po jednym miesiącu albo jednej sekcji tabeli naraz. Dokładność daje pipeline wokół niego.
- Sortuś odpowiada na podstawie harmonogramu mieszkańca, na Gemini, z danymi osobowymi usuwanymi z rozmowy.
Claude Code, Codex, Cursor, MCP, skille, subagenci, Gemini, Gemma.
Kto wygra tę rundę? Moja praca magisterska i klasyfikator zmian skórnych
Magisterka z inżynierii danych, specjalność systemy eksploracji danych (2025–2026), po licencjacie z ekonomii (2021–2024), oba na Uniwersytecie Zielonogórskim.
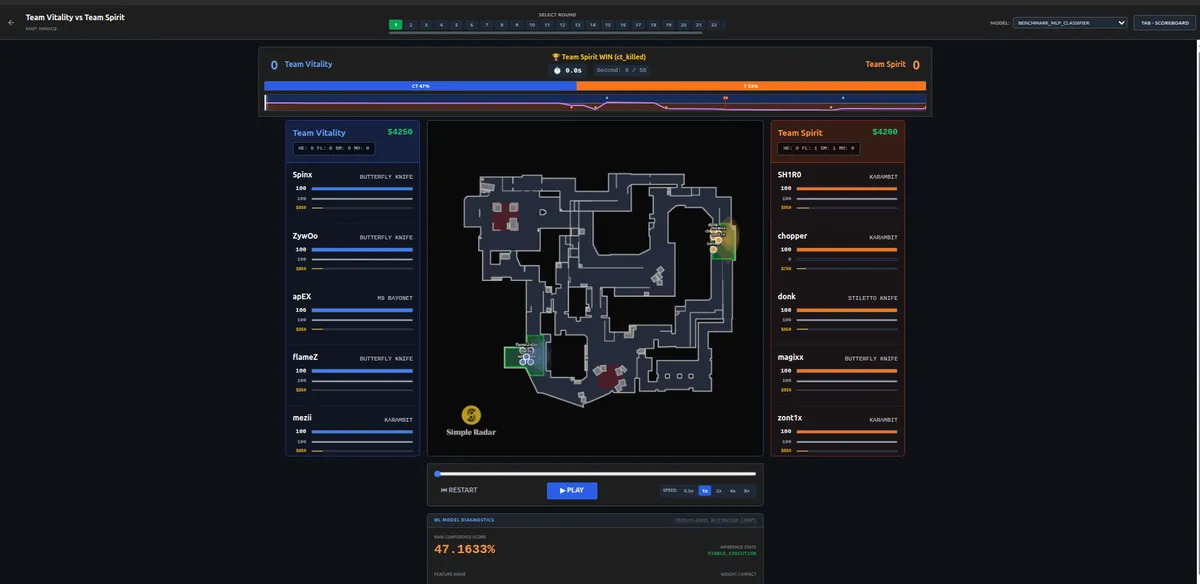
Praca magisterska: szansa na wygranie rundy w Counter-Strike 2
Model, który podaje prawdopodobieństwo wygrania rundy sekunda po sekundzie. Pobrałem zapisy profesjonalnych meczów Selenium, sparsowałem je demoparser2 i zbudowałem cechy w pandas: 9196 map, 187 361 rund i 16,8 mln stanów gry.
Porównałem dziewięć modeli z walidacją grupowaną po meczach i walk-forward po kwartałach, z testami bootstrap, ablacjami, kalibracją i SHAP. Najlepszy okazał się gradient boosting: LightGBM z log loss 0,527, ROC-AUC około 0,81–0,82 w kwartalnych testach walk-forward i oczekiwany błąd kalibracji (ECE) 0,0086 dla produkcyjnego modelu XGBoost. Predykcje serwuje FastAPI do aplikacji w React.
| Model | Log loss | ROC-AUC | Brier |
|---|---|---|---|
| LightGBM | 0,5267 | 0,8036 | 0,1790 |
| CatBoost | 0,5272 | 0,8059 | 0,1786 |
| XGBoost (produkcyjny) | 0,5289 | 0,8017 | 0,1800 |
| Las losowy | 0,5295 | 0,8035 | 0,1797 |
| MLP | 0,5323 | 0,8016 | 0,1807 |
| Extra trees | 0,5332 | 0,8043 | 0,1805 |
| Regresja logistyczna | 0,5518 | 0,7918 | 0,1858 |
| Regresja liniowa, punkt odniesienia | 0,5919 | 0,7889 | 0,1891 |
| Klasyfikator ridge | 0,6044 | 0,7889 | 0,2074 |
| Kwartał testowy | Mapy w treningu | AUC, logistyczna | AUC, XGBoost |
|---|---|---|---|
| 2024 Q1 | 844 | 0,7302 | 0,6498 |
| 2024 Q2 | 1448 | 0,7973 | 0,8049 |
| 2024 Q3 | 3519 | 0,8005 | 0,8140 |
| 2024 Q4 | 5315 | 0,8032 | 0,8183 |
| 2025 Q1 | 5999 | 0,8051 | 0,8217 |
| 2025 Q2 | 6457 | 0,8038 | 0,8190 |
| 2025 Q3 | 7172 | 0,7980 | 0,8119 |
| 2025 Q4 | 7828 | 0,8016 | 0,8142 |
| 2026 Q1 | 8770 | 0,7956 | 0,8094 |
Klasyfikator zmian skórnych
Projekt na zajęcia z uczenia maszynowego na zdjęciach HAM10000: zmiana złośliwa czy łagodna. Własna sieć CNN kontra dostrojony EfficientNet-B0 w PyTorchu, z Optuną, focal loss, ważonym samplerem, MixUp i augmentacją przy teście, plus Grad-CAM, który pokazuje, gdzie patrzy model. Na 1002 obrazach testowych EfficientNet osiągnął AUC około 0,93 i czułość 0,95 dla zmian złośliwych, a własna CNN AUC 0,755. Eksperymenty w MLflow, interfejs w Streamlit.
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/thesis, mateuszsliwa.dev/pl/skin.
storeshots i macsim, oba open source
Dwa narzędzia, które powstały przy wydawaniu aplikacji w pojedynkę, z linuksowego PC, z agentami do kodowania, które piszą sporą część kodu.
storeshots
Otwartoźródłowe narzędzie wiersza poleceń, które robi zrzuty do App Store z działającej aplikacji. Uruchamia ją w symulatorze iOS, układa ekrany w slajdy w HTML i CSS, renderuje je w dokładnych rozmiarach, których wymaga Apple, sprawdza je na wyrenderowanych pikselach (rozmiary, kanał alfa, wielkość tekstu, ucięcia, kontrast) i wysyła przez App Store Connect API. Każda komenda zwraca JSON, więc może je obsługiwać agent. Zrzuty EcoSort powyżej i w App Store powstały właśnie nim.
storeshots na GitHubieOtwórz demo
macsim
Piszę kod na linuksowym PC, a buildy iOS wymagają Maca. macsim zamienia Maca w sieci w zdalny serwer buildów i symulator iPhone'a. Jedna komenda synchronizuje projekt przez SSH, buduje go xcodebuildem albo Expo, instaluje i uruchamia, a Metro dalej działa na PC z hot reloadem. Agent na PC może klikać, pisać i robić zrzuty ekranu w symulatorze, a ja mogę oglądać go na żywo w przeglądarce. Ma dołączony skill dla Claude Code i Codexa, a używałem go przy buildach TrueSky i Keenwit.
Każdy projekt ma też własną stronę: mateuszsliwa.dev/pl/storeshots, mateuszsliwa.dev/pl/macsim.
Napisz do mnie
[email protected]. CV po angielsku albo po polsku.